
在機器視覺中,一項基本需求是將不同影像中的彩色分量分離。 例如,這可以是將 RGB 分離為其分量,也可以是將 HSL 或 XYZ 等進行分離。 以下將展示一些顏色分離的範例。 所有範例皆使用 RGB 面陣相機作為輸入。 當然,這些範例也適用於線陣相機。 此外,很可能會先進行 Bayer De-Mosaicing 或色彩空間轉換,且可以輕鬆地將其新增至範例中。
這些範例假設主機 PC 上的後續處理需要進行顏色分離。 因此,這些範例聚焦於顏色分離的 DMA 傳輸。 如果您需要在 FPGA 中對顏色分離的資料進行處理,這些範例同樣可以應用於您的需求。
以下將展示多個範例。 所有範例的結果皆相同。 然而,其實現方式完全不同,且各有其優缺點。 您需要選擇最符合您需求的範例。 下表列出了所有範例及其部分 Property。
| 範例名稱 | 延遲 | DRAM | Block RAM 數量 | DMA 輸出 |
|---|---|---|---|---|
| 三個 DMA | 無額外延遲 | 1 個 DRAM 緩衝區 | 低 | 3 個 DMA。每個顏色分量一個。 |
| 帶有 3 個緩衝區的循序 | 延遲已降至理論最小值。 | 3 個 DRAM 緩衝區 | 低 | 1 個 DMA。循序顏色分量輸出。 |
| 帶有 MultiROI Buffer 的循序 | 1 個畫面延遲與頻寬限制。 | 1 個 DRAM 緩衝區 | 正常 | 1 個 DMA。循序顏色分量輸出。 |
| 帶有預先排序 MultiROI Buffer 的循序 | 1 個畫面延遲 | 1 個 DRAM 緩衝區 | 高 | 1 個 DMA。循序顏色分量輸出。 |
| 帶有進階緩衝區用法的循序 | 1 個畫面延遲 | 1 個 DRAM 緩衝區 | 低 | 1 個 DMA。循序顏色分量輸出。 |
表 20:顏色分離範例總覽
前表中顯示的 Property 的完整說明以及不同方法的完整說明,將在後續章節中概述。
| 簡短描述 | |
|---|---|
|
檔案: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option1_ThreeDMA.va |
 |
|
預設平台: mE5-MA-VCL |
|
|
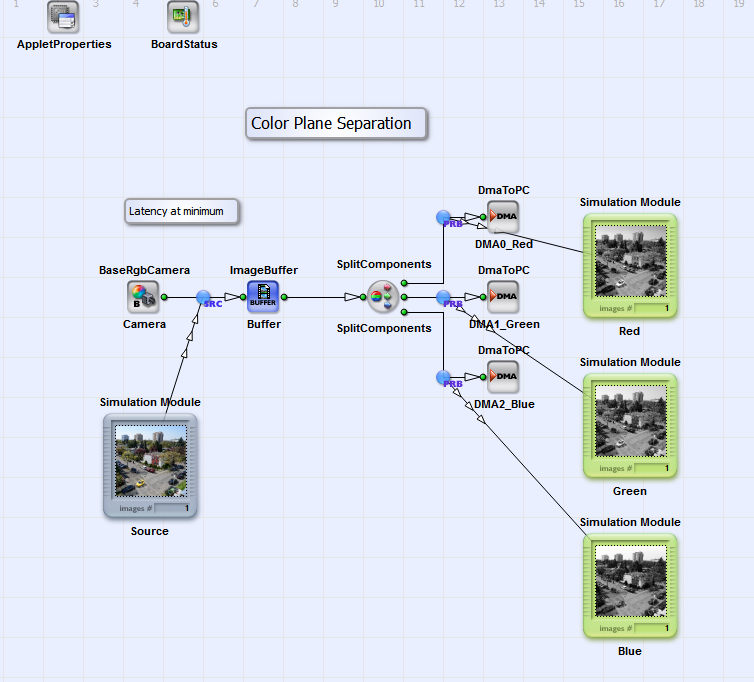
簡短說明 RGB 色彩平面分離範例。 這些元件被分割為三個 DMA 輸出通道。 |
|
此範例非常簡單。 輸入的 RGB 影像會先進行緩衝,然後色彩平面會被分割為三個輸出連結。 這三個連結會透過三個 DmaToPC 運算子傳輸至 PC。 此方案的優點是延遲極低。 影像不會在擷取卡中進行緩衝。 如果主機 PC 夠快,ImageBuffer 運算子只會將影像延遲一行。 不會產生額外的延遲。 另一個優點是只需要一個 DRAM 運算子。
此實作的缺點是需要三個 DMA 輸出運算子。 這些運算子會消耗擷取卡的許多 FPGA 邏輯資源。 如果您不需要如此極低的延遲,則應考慮後續章節中介紹的其中一種方案。
| 簡短描述 | |
|---|---|
|
檔案: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option2_ThreeBuffersOneDMA.va |
 |
|
預設平台: mE5-MA-VCL |
|
|
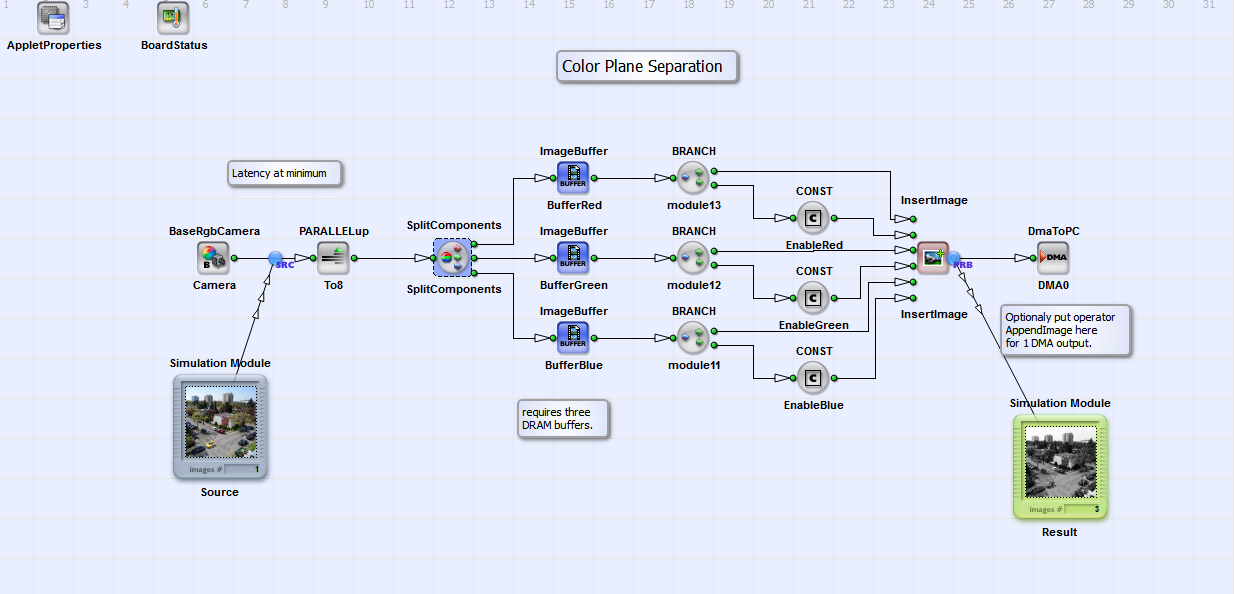
簡短說明 RGB 色彩平面分離範例。 這些元件會在三個擷取卡緩衝區中進行分割與緩衝。 之後,色彩平面會透過一個 DMA 通道依序輸出。 |
|
在此 RGB 色彩平面分離方案中,色彩平面會透過 DMA 通道以循序順序輸出。 這是透過將 RGB 輸入分割為其組成元件,並將色彩分別緩衝在三個 ImageBuffer 模組中來完成的。 使用 InsertImage 運算子,即可從 ImageBuffer 中依序讀取色彩平面。
在此範例中,重要的一點是在將資料寫入 ImageBuffer 之前增加 Parallelism。 否則,在 InsertImage 模組之後將會產生瓶頸。
此方法的優點是只需要一個 DMA 通道,因而減少了所需的資源。 此外,延遲也達到了循序輸出的理論最小值。 紅色通道的 DMA 傳輸會立即開始,毫無延遲。 此方案的缺點是需要三個擷取卡記憶體運算子。 由於這些運算子數量有限,因此本方案僅在不需要更多此類緩衝區時才適用。
| 簡短描述 | |
|---|---|
|
檔案: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option3_SequentialMultiROI.va |
 |
|
預設平台: mE5-MA-VCL |
|
|
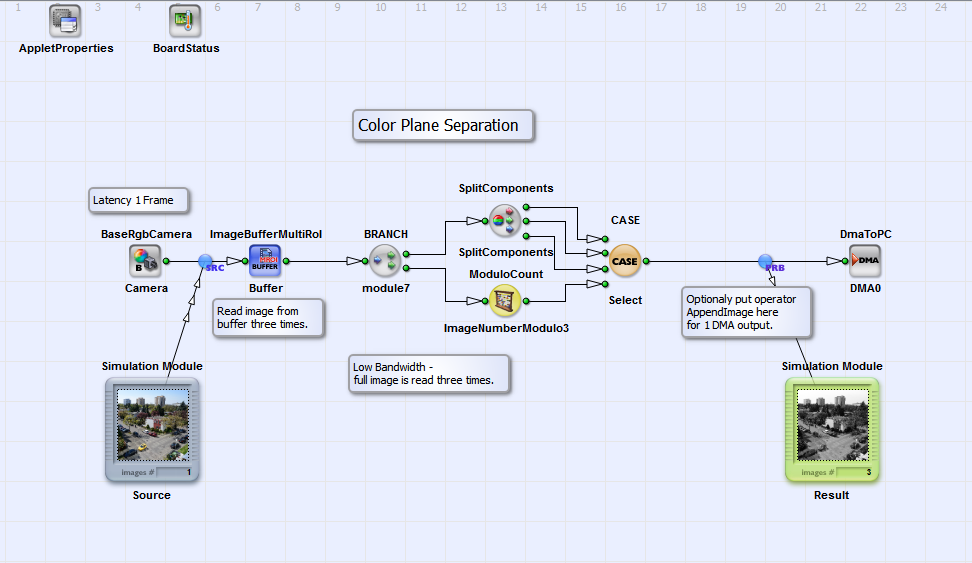
簡短說明 RGB 色彩平面分離範例。 此處執行三種 RGB 色彩平面之序列式 DMA 輸出。 該序列由ImageBufferMultiRoI 產生。 此解決方案並不理想,因為它會限制頻寬。 請參閱下一個範例,以了解最佳化解決方案。 |
|
此方案是前一個範例與下一個範例之間的過渡步驟。 由於頻寬限制,不建議實作此方案。 不過,它以簡單的方式說明瞭如何在只需要一個擷取卡 RAM 的情況下,獲得與前一個範例相同的輸出。 為了將影像序列化,我們使用 ImageBufferMultiRoI 運算子。 在此運算子中,我們單純地讀取相同的影像三次。 之後,我們為第一張影像選取紅色元件,為第二張影像選取綠色元件,並為第三張影像選取藍色元件。 這可以透過 ModuloCount 和 CASE 運算子輕鬆完成。 ModuloCount 的參數設定為對影格數進行模 3 計數,即 {0, 1, 2, 0, 1, 2, ...}。
如前所述,此方案並非最佳方案,因為它會降低頻寬。 原因在於我們讀取了相同的輸入影像三次,但每次只使用三個元件中的其中一個。 因此,在每個讀取週期中,我們都會捨棄三分之二的資料。 下一個範例將展示一個克服此限制的類似方案。
| 簡短描述 | |
|---|---|
|
檔案: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option4_SequentialPreSortMultiROI.va |
 |
|
預設平台: mE5-MA-VCL |
|
|
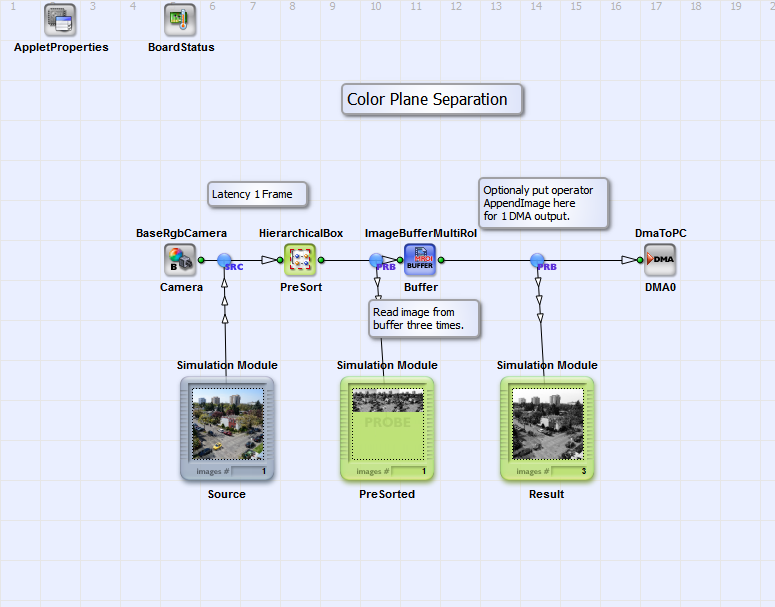
簡短說明 RGB 色彩平面分離範例。 執行三個 RGB 色彩平面的循序 DMA 輸出。 此序列由 ImageBufferMultiRoI 產生。 額外的預先排序可最佳化頻寬並解決前一個範例中提出的問題。 |
|
此範例與前一個範例類似。 相對地,在此情況下我們沒有頻寬限制。 其概念是相同的。 藉由使用 ImageBufferMultiRoI 運算子,我們將三個色彩元件序列化。 與前一個範例不同的是,我們不在緩衝區之後分離色彩。 而是改在將色彩寫入緩衝區之前進行分離。 這是在 PreSort HierarchicalBox 中完成的,其內容如 volgende 圖所示。
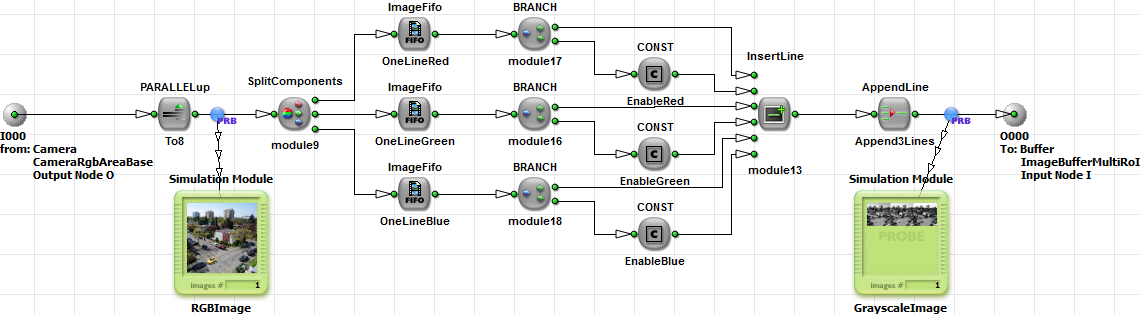
此方法的概念是在將色彩元件寫入緩衝區之前先將其分離。 這對每個影像行都會執行。 因此,我們將色彩元件分割為三個連結。 這些產生的灰階連結現在包含輸入影像的影像行。 接著,這些行會進行多工處理並附加在一起。 其結果是我們在一個大影像中包含了三個灰階影像。 紅色元件在左側,綠色在中間,藍色在右側。 請查看下一圖中的模擬結果以了解其實作方式。
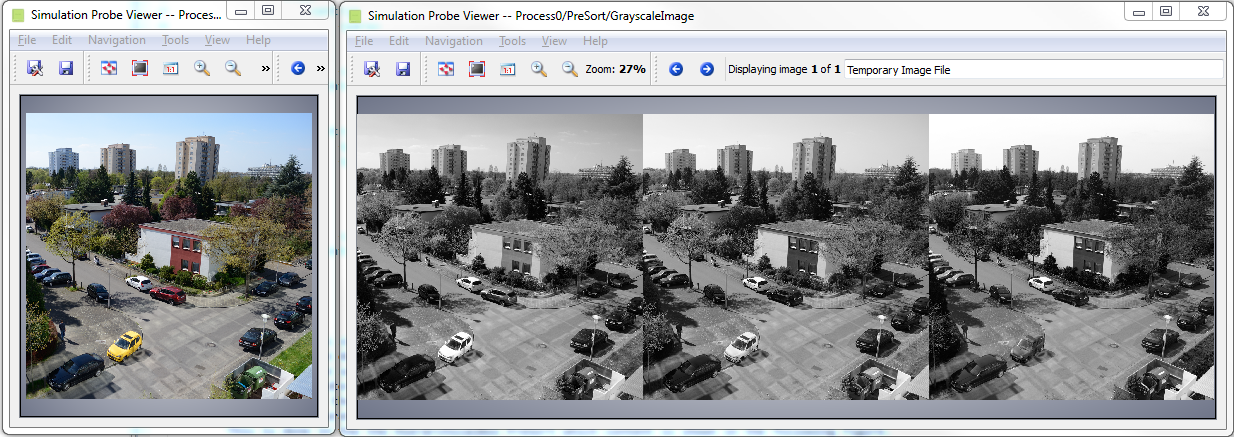
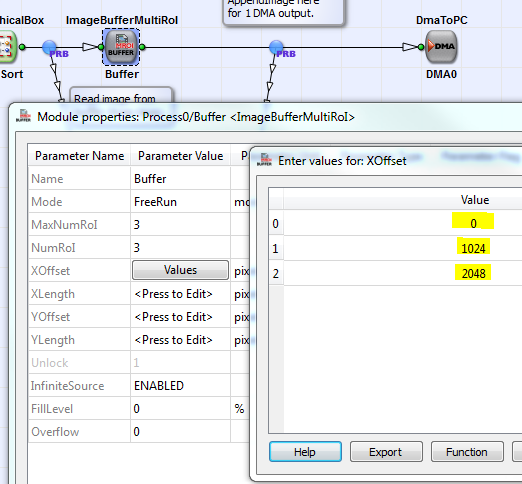
在 ImageBufferMultiRoI 中,我們現在必須先讀取左側部分。 之後是中間部分,最後是右側部分。 因此,我們需要為每個 ROI 設定不同的 XOffset,如下所示。
在使用時,別忘了如範例所示,在分離元件之前先增加 Parallelism。 這是避免在 InsertLine 模組之後產生瓶頸所必需的。 由於我們傳輸的是灰階 8 位元影像而非 24 位元 RGB 影像,因此我們需要的 Parallelism 至少要比輸入高三倍。
此解決方案僅需要一個 DRAM operator,且不會限制頻寬。 這是一個最佳化的解決方案。 不過,需要一些 block RAM 來緩衝 FIFO 中分離的色頻行。 對於小影像而言,這應該不會造成問題。 然而,如果您有很大的影像寬度(例如每行 16384 個像素),則需要大量的 block RAM。 最後的這個缺點可以透過下一個範例來解決。
| 簡短描述 | |
|---|---|
|
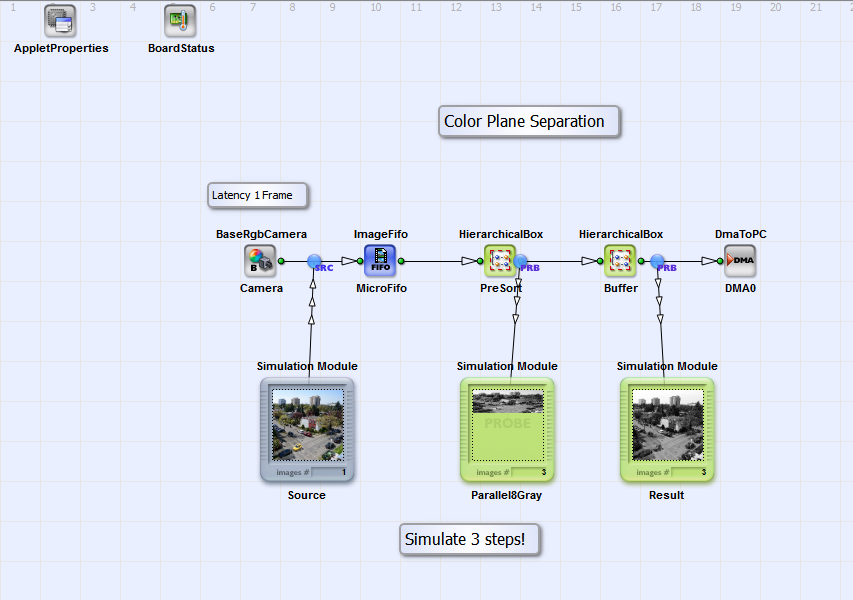
檔案: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option5_SequentialAdvanced.va |
 |
|
預設平台: mE5-MA-VCL |
|
|
簡短說明 色頻分離範例。 RGB 輸入會被分割為其色頻,並透過一個 DMA 通道依序輸出。 分割是透過平行收集相同的色頻並使用 FrameBufferRandomRead 進行讀取來執行的。 |
|
這是 VisualApplets 中色頻分離最高階的範例。 它著重於最低的資源使用率與最高的頻寬。 先前的範例使用預先排序來分離色彩分量,以便我們可以從緩衝區中個別讀取它們。 然而,預先排序中的 FIFO 需要一些 block RAM。 在此方法中,我們同樣使用預先排序。 相對地,我們在切換到下一個色頻之前,只收集每個色頻的 8 個連續像素。 在先前的範例中,我們在切換到下一行之前收集了一個色頻的完整行。 此修改帶來的結果是我們不再需要 FIFO。 不過,在這種情況下無法使用 ImageBufferMultiRoI。 取而代之的是,我們必須使用 FrameBufferRandomRead。
預先排序很簡單。 首先,我們將 Parallelism 增加到八。 接著,分割色頻。 這會產生三個鏈結,每個鏈結具有 8 的 Parallelism。 MergeParallel 現在會將這些色頻的第八個像素放入序列中。 因此我們將獲得以下序列:R0 到 R7、G0 到 G7、B0 到 B7、R8 到 R15、G8 到 G15、B8 到 B15、...
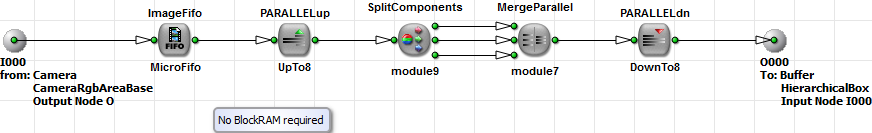
輸入端的 FIFO 是因為 PARALLELdn 從 16 降到 8 而需要的。 此 FIFO 僅用於避免 DRC 等級 2 錯誤。 事實上,它不需要緩衝資料,因此我們將其大小設為僅 2 個像素的非常小尺寸。
在我們對像素進行預先排序之後,它們會被緩衝在 FrameBufferRandomRead operator 中。 這個 operator 具有讀取列與行位址輸入,並允許隨機讀取資料。
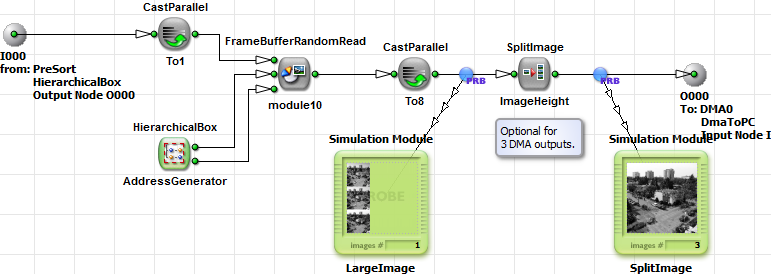
該 operator 只能在 Parallelism 為一的情況下使用。 因此,我們使用 CastParallel 將每像素 8 位元的 8 Parallelism 轉換為每像素 64 位元的 1 Parallelism。 這就是為什麼我們在前一個步驟中收集了八個連續像素。
為了分離色頻,我們必須將位址增加二以跳過不需要的色彩。 因此,對於紅色色頻,讀取位址將會是:RColA(0) = 0, RColA(1) = 2, RColA(2) = 5, ... 對於綠色色頻,讀取位址將會是:RColA(0) = 1, RColA(1) = 3, RColA(2) = 6, ... 階層式方塊 AdressGenerator 會產生這些讀取位址。 CreateBlankImage operator 定義所需的影像尺寸。 由於我們先前已將 CastParallel 從 8 轉換為 1,因此我們必須使用除以 8 的影像寬度。
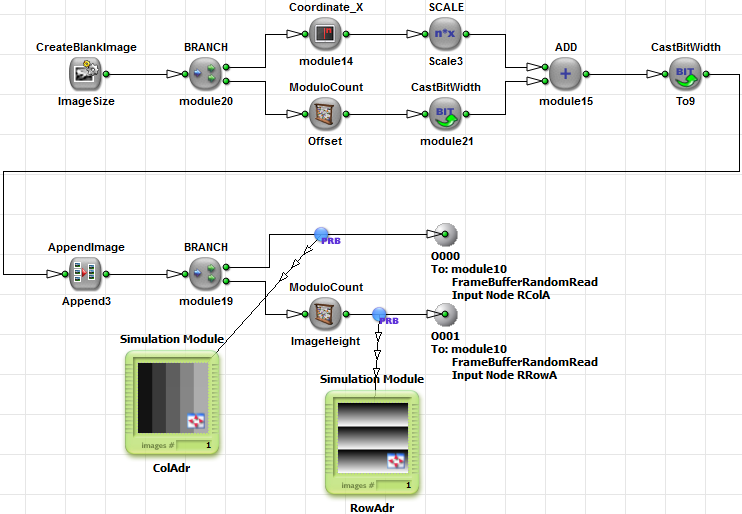
行位址只需透過將 Coordinate_X 輸出以 Scaling 3 來產生。 根據目前的色頻,我們將 0、1 或 2 作為偏移量加到這些值中。
透過使用 AppendImage,這三個位址影像被合併為一個較大的影像。 行位址只需透過 0 與影像高度之間的 Counter 來產生。 在此情況下,我們使用 ModuloCount operator 來執行此任務。 現在可以將位址饋送到 FrameBufferRandomRead operator 中。 切記在 CreateBlankImage 輸出端使用 2 的 Parallelism,以最大化 FrameBufferRandomRead 的效能。
在緩衝區之後,我們會獲得一個大型影像,其中前幾行包含紅色影像,接著包含綠色影像,最後包含藍色影像。 為了將這個大型影像分割為三個獨立的 DMA 輸出,我們使用 SplitImage 並設定影像高度。
了解實作方式最簡單的方法是逐步檢視中間結果。 請注意,您需要為一個結果影像模擬三個步驟。 這是因為必須由 CreateBlankImage operator 產生 3 張影像。
此解決方案經過資源最佳化,只需要少量的 block RAM 資源。 此外,FPGA 邏輯資源也獲得了有效利用。 位址產生只需少量的資源。
 上一頁

